
我们在俄亥俄州新奥尔巴尼的吉瓦级超级集群 Prometheus 上训练了 Muse 基础模型,包括 Muse Wonder。
一个拥有数十万张 GPU 的超级集群,即使只有一台主机表现不佳,也可能拖慢整个训练过程。我们针对大规模运行的可靠性设计了 Prometheus。在 Muse Wonder 训练期间,预训练的有效吞吐率超过 85%,强化学习超过 90%,平均每约 4.7 万 GPU 小时才发生一次中断。
看看 Prometheus 背后的技术:go.meta.me/4yXXApZ
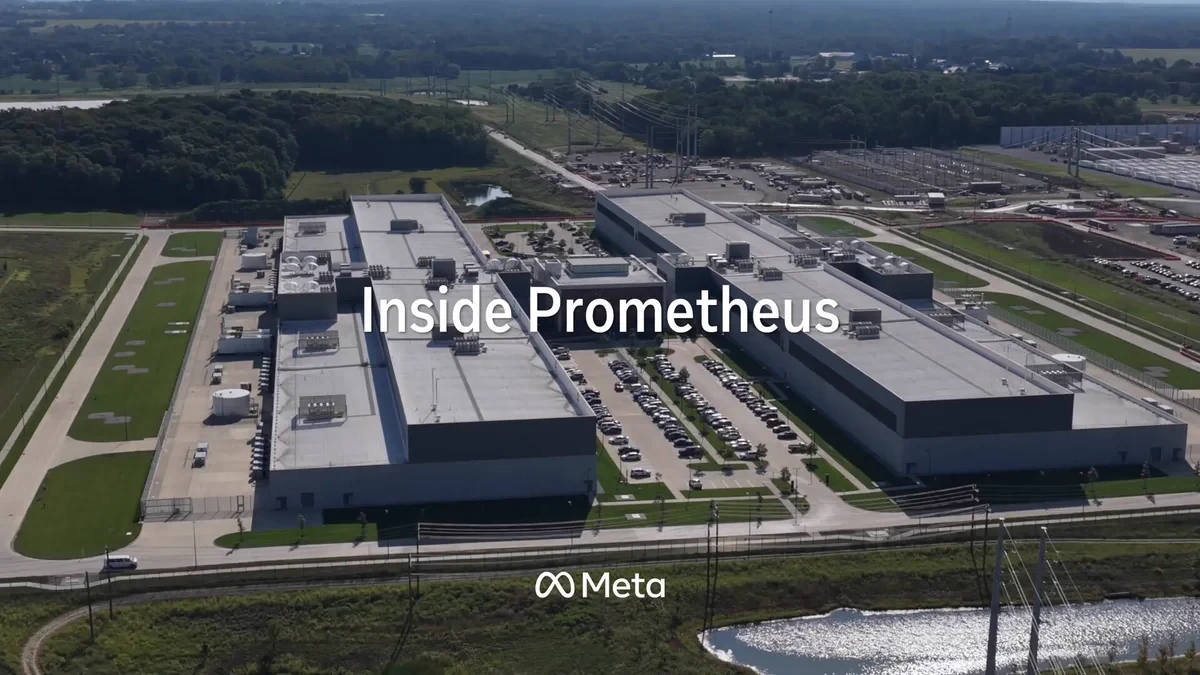
我们在俄亥俄州新奥尔巴尼的吉瓦级超级集群 Prometheus 上训练了 Muse 基础模型,包括 Muse Wonder。
一个拥有数十万张 GPU 的超级集群,即使只有一台主机表现不佳,也可能拖慢整个训练过程。我们针对大规模运行的可靠性设计了 Prometheus。在 Muse Wonder 训练期间,预训练的有效吞吐率超过 85%,强化学习超过 90%,平均每约 4.7 万 GPU 小时才发生一次中断。
看看 Prometheus 背后的技术:go.meta.me/4yXXApZ